Роботизированная кисть научилась ходить на своих же пальцах. Часть 2: как устроено обучение и что дало прирост
Это продолжение разбора. В первой части разобрано, что робот умеет: ползает на кончиках пальцев, встаёт после падения, нажимает клавиши и толкает кубик к цели, со всеми числами. Здесь про то, как его этому научили, и почему в статье авторы столько места отводят одному слагаемому в формуле награды. Будет несколько формул, каждая с объяснением словами.
Сразу три слова, которые дальше встречаются постоянно. Политика это обученная программа поведения: она смотрит на показания датчиков и выдаёт следующую команду. Обучение с подкреплением это способ её получить: политику многократно запускают в модели мира и поощряют за желаемый итог числом, которое называют наградой. PPO это распространённый метод такого обучения, который меняет политику небольшими шагами, чтобы она не разваливалась от резких правок.
Источник один: препринт arXiv:2609.17172. Все числа об этой работе ниже из него, с пометкой, получены они в симуляции или на железе. Сроки в примере про автоматизацию в конце статьи к препринту отношения не имеют: это мой пример.
Почему нельзя взять готовый рецепт для четвероногих
Обучение походке для шагающих роботов давно отработано. Но один привычный приём здесь неприменим по устройству задачи, а от второго авторы отказались сознательно.
Симметрия. У четвероногого робота есть зеркальная симметрия слева направо, и её активно используют: добавляют в обучение штраф за несимметричность, отражают примеры, строят сети, которые ведут себя одинаково при отражении. Для всего этого нужно такое отражение состояний и действий, при котором награда не меняется. У кисти с противопоставленным большим пальцем и четырьмя неодинаковыми пальцами такого отражения нет.
Расписание шагов. Это уже выбор авторов, а не запрет. Награды для шагающих роботов часто задают время: какой ноге когда быть в воздухе, какой на земле, с какими сдвигами фаз между ними. Авторы пошли иначе: их слагаемое задаёт место, а не время. Каждый кончик пальца притягивается к своей собственной точке, снятой с устоявшейся стойки, а когда и какой палец шагнёт, решает сама политика.
Есть и третья трудность, чисто геометрическая: ладонь в стойке стоит наклонно, поэтому система координат самого тела не годится как горизонтальный отсчёт для команд движения.
Система отсчёта, из которой убрали наклон
Опорную стойку получают так: в симуляции с грузом 80 грамм держат фиксированные цели суставов 4 секунды, потом сохраняют устоявшееся положение корпуса и углы суставов.
Дальше вводится система отсчёта V. Она получается из системы корпуса поворотом, который выравнивает эту стойку по горизонтали и направляет ось «вперёд» по горизонтальному вектору от ладони к центру оснований дальних звеньев четырёх пальцев от указательного до мизинца. Формально это произведение текущего поворота корпуса на фиксированный поправочный поворот.
Тонкость, которую авторы отмечают отдельно: дальше V следует за поворотом корпуса, а не остаётся всё время выровненной по силе тяжести. То есть наклон ладони, свойственный стойке, убран, но движения тела при этом не подавляются.
Награда: виртуальные пружины вокруг отпечатка
Главное слагаемое авторы называют footprint objective, слагаемым за отпечаток. Оно устроено так.
Для каждого из пяти кончиков пальцев есть своя опорная точка. Каждая среда снимает её при первом вычислении награды после создания и дальше держит неизменной при сбросах. Положение кончика при этом считается относительно корпуса, в той самой системе V, поэтому точки едут вместе с телом. Для кончика с номером j берут разность между его текущим положением и опорным, и считают:
r̄ = Σ (p_j − p_j)ᵀ · W · (p_j − p_j), где W = diag(0,25; 1; 1)**
Словами: для каждого пальца берут три составляющие отклонения от его точки (вдоль хода, вбок и по высоте), каждую возводят в квадрат, умножают на свой вес и складывают по всем пяти пальцам. Вес вдоль хода равен 0,25, вбок и по высоте единице, то есть боковые и вертикальные отклонения штрафуются вчетверо сильнее продольных.
В награду это входит с коэффициентом минус 30, то есть как штраф.
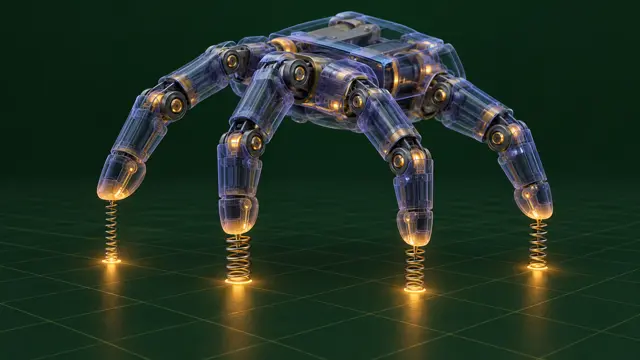
Почему это именно пружины: выражение вида «вес, умноженный на квадрат смещения» это ровно та формула, по которой считают энергию, запасённую в пружине. Получается, что каждый кончик пальца как бы привязан к своей точке тремя пружинами разной жёсткости: мягкой вдоль направления движения и жёсткими вбок и вверх. Мягкая пружина вдоль хода делает шаг дешёвым, жёсткие боковые и вертикальные отговаривают кисть расползаться.
Две оговорки авторов, которые легко пропустить. Первая: эти жёсткости это веса в награде, а не коэффициенты регулятора, то есть они влияют на обучение, а не на то, как железо отрабатывает команду. Вторая: опорные точки двигаются вместе с телом и не задают ни точек на земле, ни очерёдности шагов.
Два вспомогательных слагаемых
За подъём. Это слагаемое подталкивает частоту шагов, растущую вместе с заданной скоростью. Внутри считается фаза, которая на каждом шаге увеличивается на 2π·f·Δt, где Δt равно 20 миллисекундам, а частота f линейно переводит скорость от 0,02 до 0,16 метра в секунду в частоту от 1 до 3,5 герц, с ограничением на концах диапазона.
Вертикальная скорость кончика пальца умножается на комплексную экспоненту от этой фазы и усредняется скользящим средним с постоянной времени 0,3 секунды. Если убрать математику: эта конструкция измеряет, насколько подъёмы пальца попадают в такт с нужной частотой, и поощряет попадание. Сама фаза политике не показывается, она её не видит.
Засчитывается подъём только при трёх условиях: кончик в воздухе (сила меньше 0,15 ньютона), с момента последнего оборота фазы у этого пальца был контакт, и заданная скорость не ниже 0,02 метра в секунду.
Вес этого слагаемого меняется по ходу обучения: 6,25 первые 18 000 шагов на среду (это 750 из 8 000 итераций обучения), затем геометрически спадает до 0,625 за следующие 36 000 шагов и там остаётся.
За направление. Штрафуется составляющая скорости кончика пальца, направленная против команды, и только при двух условиях сразу: сила на кончике ниже порога (палец в воздухе) и задана ненулевая скорость движения. Смысл: опирающимся пальцам нужно двигаться назад относительно корпуса, иначе они не толкают тело вперёд, а вот маховые движения назад бесполезны.
Отдельная деталь про порядок обучения: отслеживание скорости поворота включается не сразу, а на той же отметке 18 000 шагов, когда уже сформировалась походка вперёд, чтобы политика не училась шагать и поворачивать одновременно.
Симулятор, откалиброванный по железу
Политики действуют через встроенный регулятор положения кисти, поэтому симулятор калибровали по измеренному отклику именно на сглаженные команды положения: частотные развёртки суставов, нагруженные протяжки кончика пальца, замеры времени отклика.
| Что измеряли | Что получили |
|---|---|
| Множитель жёсткости сустава относительно исходной модели | от 15 до 22 (в среднем 18,7 плюс-минус 2,5) |
| Кинетическое трение кончика пальца | 0,88 (диапазон от 0,80 до 0,97) |
| Задержка в замкнутом контуре | около 19 мс |
| Скорость сустава после фильтра | 2,8 и 2,5 рад/с (сгибание и отведение) |
| Частота среза фильтра команд | 3 Гц |
Множитель жёсткости в 18,7 раза относительно исходной модели стоит отдельного внимания: он показывает, насколько сильно откалиброванная модель разошлась с исходной. Чем обернулся бы перенос без этой калибровки, в работе не проверялось.
Что именно обучали
Политика это обычная полносвязная сеть прямого распространения, обученная методом PPO. На борту она работает 50 раз в секунду и выдаёт не углы, а приращение к целевым положениям суставов: приращение считается как масштаб, умноженный на гиперболический тангенс выхода сети, и прибавляется к прежней цели с соблюдением пределов. Масштаб разный у задач: 0,060 радиана для ползания и вставания, 0,028 для клавиатуры, 0,040 для толкания.
Входы у всех политик общие: 20 углов суставов относительно опорных, единичный вектор направления силы тяжести, угловая скорость и предыдущий выход политики, итого 46 величин на шаг. К ним добавляются задачные: у ползания это команда движения по плоскости (два числа) и команда скорости поворота (одно). Каждая величина хранится по восемь последних значений, потом всё склеивается и нормируется по зафиксированной статистике обучения. В таблице обучения вход актора указан как 392 при выходе 20, что сходится с 49 величинами по восемь значений.
Условия обучения политики ползания:
- 4096 параллельных сред (то есть 4096 копий задачи считаются одновременно), эпизод 20 секунд;
- скрытые слои актора 512, 256, 128 с активацией ELU;
- физика при 200 Гц, одно действие политики на четыре шага физики;
- 8 000 итераций PPO плюс ещё 5 000 на приспособление к грузу и условиям контакта;
- в обновлении PPO 24 шага на среду, пять эпох, четыре мини-партии, отсечение 0,2, адаптивный шаг обучения от 0,001 (эта группа настроек сдерживает размер правки политики за один раз: отсечение снижает выгоду от слишком больших изменений, чтобы обучение не прыгало);
- коэффициент дисконтирования 0,99, обобщённая оценка преимущества с коэффициентом 0,95, коэффициент энтропии 0,005 (эта группа задаёт, насколько далеко вперёд политика смотрит при оценке последствий и насколько ей позволено пробовать разное вместо повторения найденного);
- команды при обучении: продольная скорость от 0 до 0,16 м/с, поперечная от минус 0,16 до 0,16 м/с, поворот от минус 0,45 до 0,45 рад/с;
- эпизод прерывается при касании ладонью, крене больше 35 градусов или тангаже больше 30 градусов.
Две детали, важные для понимания устройства. Первая: в таком обучении участвуют две сети. Актор это и есть политика, которая действует. Критик это вторая сеть, которая только оценивает, насколько хорошо идут дела, и нужна лишь во время обучения. При обучении критик дополнительно видит состояние корпуса, моменты в суставах и силы контакта кончиков, то есть то, чего у актора на железе нет. Это обычный приём, когда оценивающей части дают больше сведений, чем действующей. Вторая: разнообразие при обучении охватывает трение кончиков, масштаб усилия, смещения центра масс груза, массу ладони, её центр масс и смещение нуля датчика наклона, а коэффициенты привода меняются вокруг откалиброванной жёсткости.
Что показало выключение слагаемых
Здесь самая аккуратная часть работы. Сравнивали семь настроек: авторскую, четыре с выключенными слагаемыми и два эталона на основе наград из готовой задачи ходьбы четвероногого робота ANYmal-D, исходный и подобранный под эту кисть.
Устройство сравнения: каждая настройка обучалась на одних и тех же двенадцати случайных начальных значениях, по 4096 сред и 8 000 итераций, потом каждая политика проверялась в 256 эпизодах на ровном полу. Отдельно отмечено, что веса авторской формулировки зафиксировали по итогам работы с железом ещё до сравнения и не подбирали заново, а подобранный эталон получили перебором 24 случайных наборов весов. Это честная оговорка не в свою пользу: эталон подбирали под это сравнение, а авторские веса для него не перенастраивали, хотя до того они были выбраны по итогам работы с железом.
Результаты (всё в симуляции):
- Против подобранного эталона авторская награда быстрее в среднем на 0,65 см/с, доверительный интервал 95% от 0,26 до 1,02, быстрее в 10 начальных значениях из 12.
- Выключение слагаемого за отпечаток снижает скорость на 0,79 см/с (интервал от 0,37 до 1,19) и снижает участие пяти пальцев.
- Вспомогательные слагаемые за подъём и за направление: сравнение не установило их независимой прибавки к скорости, ни по отдельности, ни вместе. Больше того, выключение одного только слагаемого за направление увеличивает участие пяти пальцев на 0,31 (интервал от 0,07 до 0,52). Авторы сохраняют его в описанной формулировке по честной причине: именно с ним обучались политики, которые поехали на железо.
Доверительный интервал тут стоит читать буквально: если он не включает ноль, прибавка считается установленной, а если включает, эффект не установлен. Поэтому фраза «не дали независимой прибавки» означает именно отсутствие доказательства, а не доказательство отсутствия.
Почему мало смотреть на одну скорость
Отдельно авторы вводят две меры, помимо скорости.
Участие пяти пальцев: доля эпизодов, в которых каждый кончик коснулся земли минимум три раза и провёл в контакте не меньше 5% эпизода. Проще говоря, мера того, что кисть не ползёт на трёх пальцах, волоча два.
Положение контакта: касание различают по наклону оси подушечки относительно горизонтали в сторону ногтя. Доля посадки худшего кончика считается как доля времени контакта ниже 64 градусов для того пальца, который чаще других опирается ногтевой стороной.
Зачем это нужно, видно из сравнения: у подобранного эталона среднее участие пяти пальцев выше (хотя разница неопределённа), но он в каждом прогоне чаще ставит пальцы на ноготь. У авторской формулировки выше участие без ногтевых контактов: плюс 0,35 с интервалом от 0,18 до 0,53. То есть одна только скорость спрятала бы, чем именно кисть касается пола. Износ пальцев при опоре на ногтевую сторону это уже возможный практический риск, а не измеренный результат: износ в работе не измеряли.
Честность и тут соблюдена: при рабочем весе слагаемое за отпечаток сдвигает средний наклон контакта на 8,8 градуса в сторону ногтя (интервал от 1,4 до 15,9). То есть оно улучшает участие пяти пальцев, но не улучшает все стороны положения контакта.
Ещё один результат про веса: удвоение веса отпечатка даёт более высокую долю посадки худшего кончика, чем удвоение веса подъёма (парная разность 0,22, интервал от 0,11 до 0,33, в 10 прогонах из 12), а разница по скорости между ними неопределённа. Выше рабочего веса доля посадки продолжает улучшаться, среднее участие пяти пальцев достигает наибольшего значения при удвоенном весе и снова снижается при увеличении в 3,3 раза. Все эти большие веса проверялись только в симуляции.
Вставание и работа с предметами
Политика вставания обучена тем же методом: эпизод 20 секунд начинается с кисти, лежащей на боку со случайным направлением, награда штрафует отклонение ладони от горизонтали и поощряет выход на высоту и позу стойки для ползания, досрочного прерывания нет. После подъёма политика удерживает кисть непрерывным движением суставов, а затем плавный переход за 1,5 секунды приводит её в неподвижную стойку. На железе этот переход запускает определитель вертикального положения: наклон относительно стойки ниже 10 градусов и угловая скорость ниже 4 рад/с в течение полусекунды.
Политики для клавиатуры и толкания используют тот же откалиброванный симулятор, ту же историю измерений и ту же реализацию PPO. Актор три скрытых слоя 512, 256, 128, критик 256, 128, 64, и критик при обучении дополнительно получает скрытое состояние симуляции.
Отдельного внимания заслуживает модель камеры при обучении толканию: частота 60 Гц по схеме выборки с удержанием, задержка от одного до трёх шагов управления, потеря 3% кадров и шум положения 2 миллиметра. То есть несовершенства настоящей камеры заложили в обучение заранее.
Что из этого стоит забрать
Три вещи, которые применимы далеко за пределами робототехники.
Первая: когда привычный приём не подходит из-за устройства задачи (здесь это отсутствие симметрии), стоит смотреть на постановку, а не только на способ решения. Авторы заменили «расписание шагов» на «место для каждого пальца» и получили формулировку, которая не требует одинаковости частей.
Вторая: разницу между моделью и реальностью здесь закрывали измерениями. Множитель жёсткости в 18,7 раза показывает, насколько велика была эта разница у одной только жёсткости суставов.
Третья: меру успеха стоит выбирать заранее и не одну. Если бы авторы мерили только скорость, разница в том, чем кисть касается пола, осталась бы незамеченной.
Как это применить к выбору первой задачи для автоматизации у себя. Возьмите задачу, где результат считается числом, и выпишите заранее две меры: главную (например, сколько заявок обработано за смену) и охранную, которая ловит способ достижения (например, доля заявок, по которым потом пришла жалоба или переделка). Дальше нужен отсчёт: обе меры считаются по месяцу до внедрения и по месяцу после, по вашим собственным записям и без споров о формулировках. По двум этим мерам решение считается удачным, если главная выросла, а охранная не ухудшилась. Это ещё не вывод об окупаемости: рядом нужно положить расходы на внедрение и на поддержку и сравнить их с выигрышем в деньгах. Пересматривать решение стоит в трёх случаях: охранная мера ухудшилась (то есть выигрыш получен за счёт качества), главная не сдвинулась за два месяца, или расходы на поддержку оказались выше полученной пользы. И если охранную меру посчитать нечем вовсе, для первой автоматизации лучше взять другую задачу, иначе проверять будет нечем.
Я занимаюсь ИИ-агентами и автоматизацией. Если хотите посмотреть мои проекты или обсудить свою задачу, загляните в портфолио.
Источники
- Amirhossein Kazemipour, Hehui Zheng, Robert Katzschmann. Fingers as Legs: Learning Self-Supported Locomotion and Manipulation with an Anthropomorphic Hand. Препринт, arXiv:2609.17172, подан 15.09.2026, разделы III, IV и VI-A. https://arxiv.org/abs/2609.17172